最近好多人在问 AI语音通话对话 到底是怎么做出来的,为啥有的听起来像真人聊天,有的却像机器人念稿子,卡顿、抢话、答非所问全占了。我自己折腾过几套方案,也踩了不少坑,今天就用大白话聊聊,AI语音通话对话怎么实现自然流畅,顺便把中间那些容易翻车的地方都点出来,不管你是做开发的还是纯好奇想玩玩的,看完都能有个底。
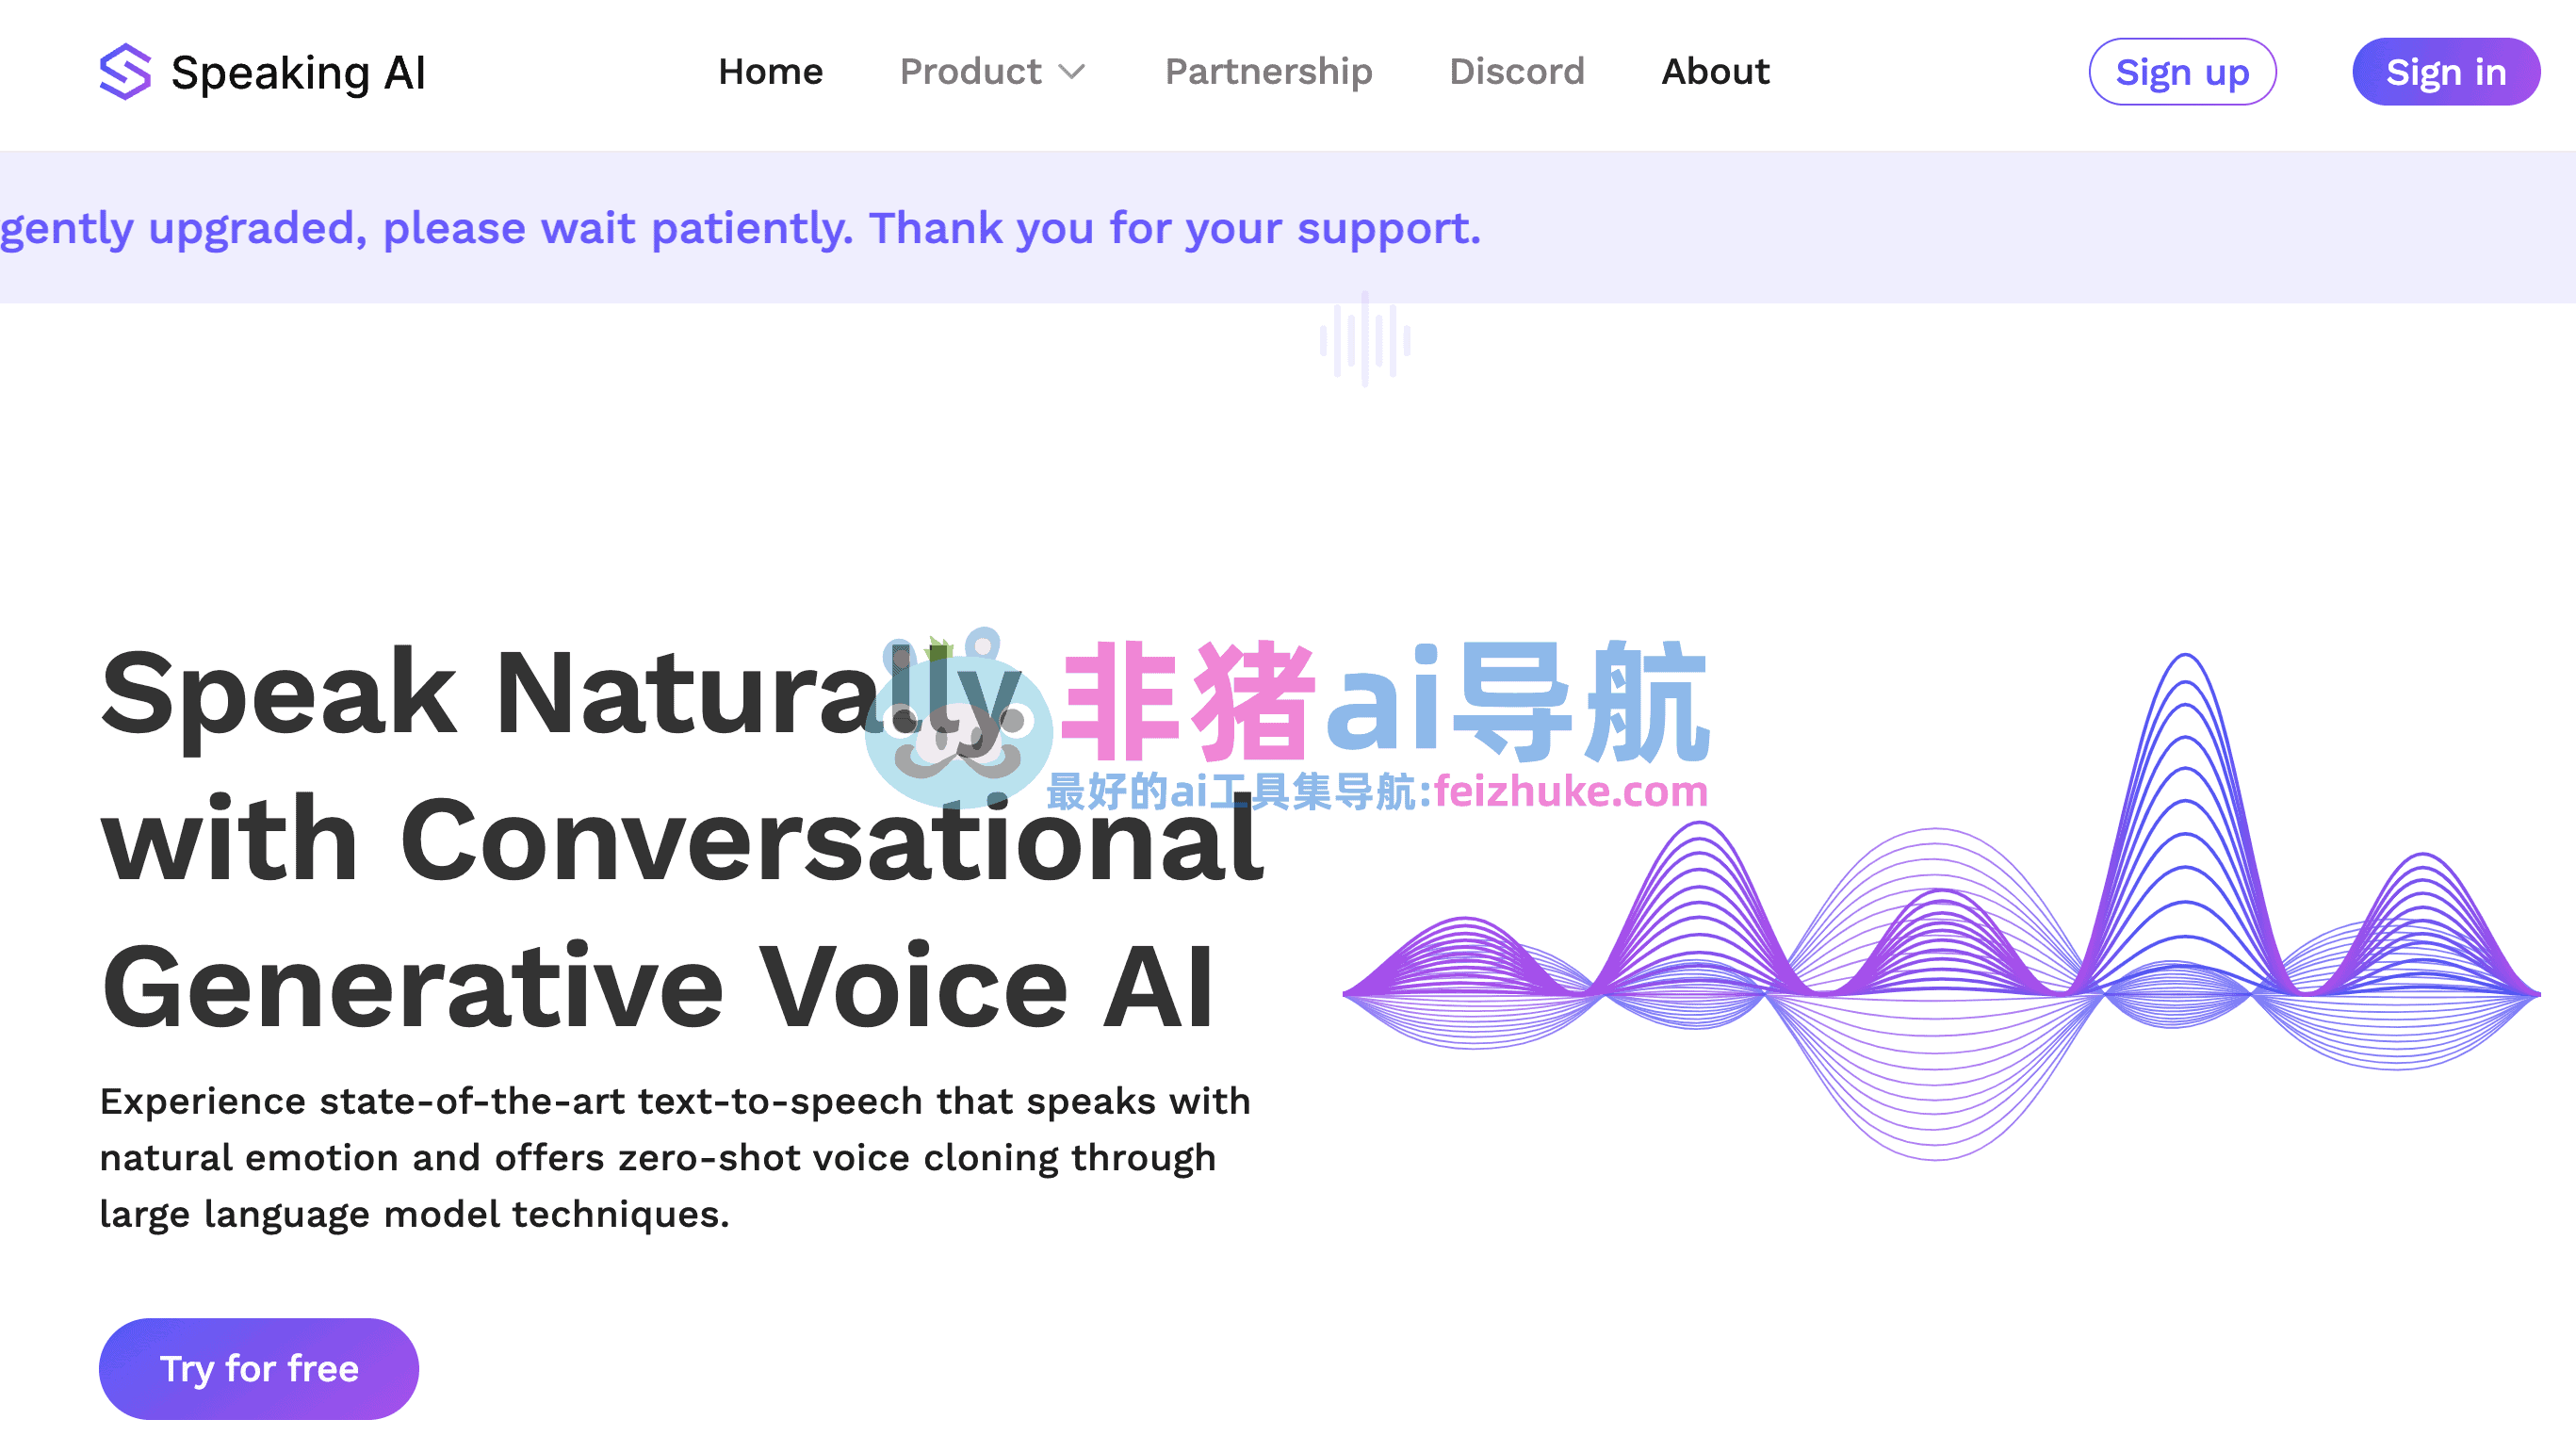
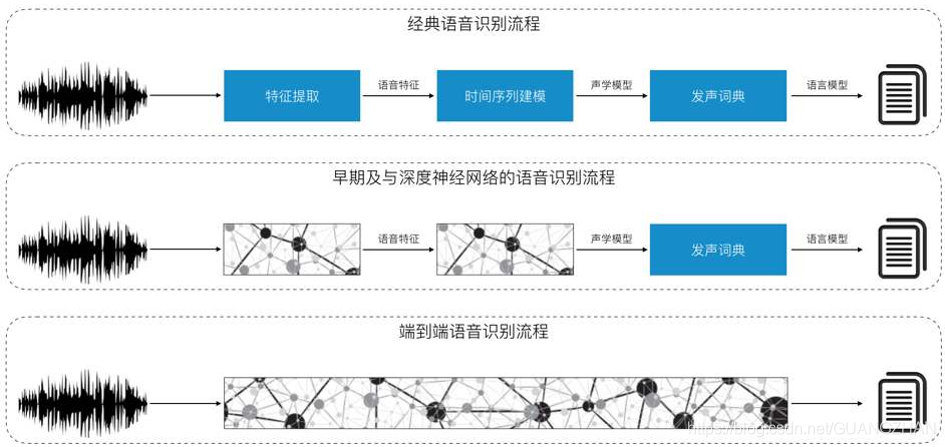
先搞明白:AI语音通话对话到底在跑什么流程
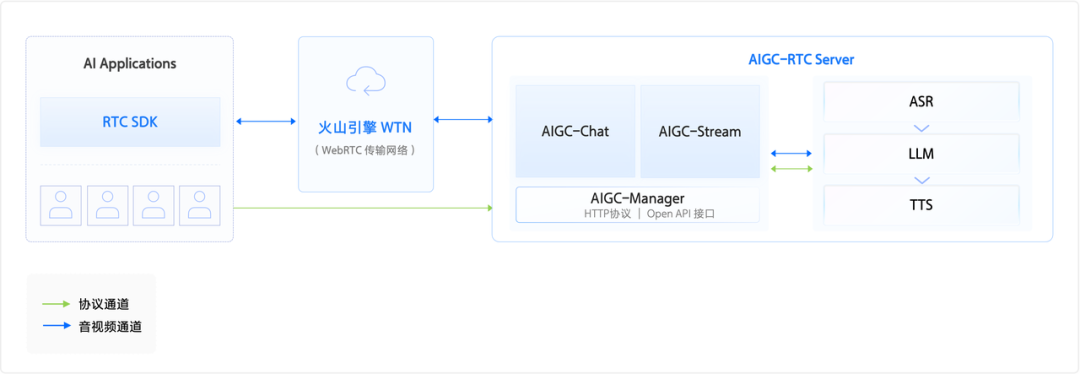
说白了,一次完整的 AI语音通话对话,背后至少跑了三件事。第一是听,也就是把你的声音转成文字,这一步叫语音识别;第二是想,把文字丢给大模型去理解、去生成回复内容;第三是说,把生成的文字再转回声音播出来。这三步里任何一步慢了半拍,对话就会显得不自然。我最早做测试的时候,光顾着换大模型,结果识别延迟高得离谱,你说完它愣两秒才回,那体验直接废了。所以别只盯着模型参数看,整条链路的耗时都得抠。
语音识别这一环,坑比想象中多
很多人以为语音识别现在很成熟了,随便调个接口就行。真上手才发现,环境噪音、口音、语速快慢都会影响结果。我试过在稍微嘈杂点的地方说话,识别出来的文字缺字漏字,后面大模型再聪明也救不回来。想让 AI语音通话对话 自然,识别这块得做点预处理,比如降噪、回声消除,尤其是通话场景有扬声器外放的时候,不处理直接互相干扰。另外断句也很关键,识别引擎如果不会自动断句,一大段文字糊在一起,模型理解起来也费劲。我后来学乖了,在识别和模型之间加了一层轻量处理,把语气词、重复词稍微规整一下,整体流畅度能提不少。
大模型回复要像人,得管住它的“嘴”
到了生成回复这一步,AI语音通话对话 最容易暴露机器味。模型默认输出经常是书面语,什么“您好,根据您的问题,我建议……”这种,念出来特别假。我一般会写一段系统提示词,让它用短句、口语、别用列表、别重复问题。还有一点,回复长度得控制,通话场景里没人想听你念小作文,一两句话说完最好。另外要加打断机制,用户说话的时候模型得停下来听,不然各说各的,那就不叫对话了。这块我踩过坑,一开始没做打断,结果用户插话它还在那播,尴尬得要命。
语音合成想自然,别只选一个音色就完事
最后一步是把文字转成声音。现在 TTS 进步很大,但想做到 AI语音通话对话 自然流畅,光选个好听的音色远远不够。语速、停顿、重音都得调。比如疑问句结尾要上扬,陈述句要平稳,这些细节靠默认参数出不来。我通常会根据回复内容动态调一下语速,短回复稍微快一点,长解释放慢些。还有呼吸感,真人说话有换气停顿,合成语音如果一口气念到底,听着就累。有些 TTS 支持插入停顿标记,加几个进去,效果立马不一样。另外音色一致性也得注意,别上一句还是温柔女声,下一句变新闻播报,那太出戏了。
延迟和打断,才是流畅感的生死线
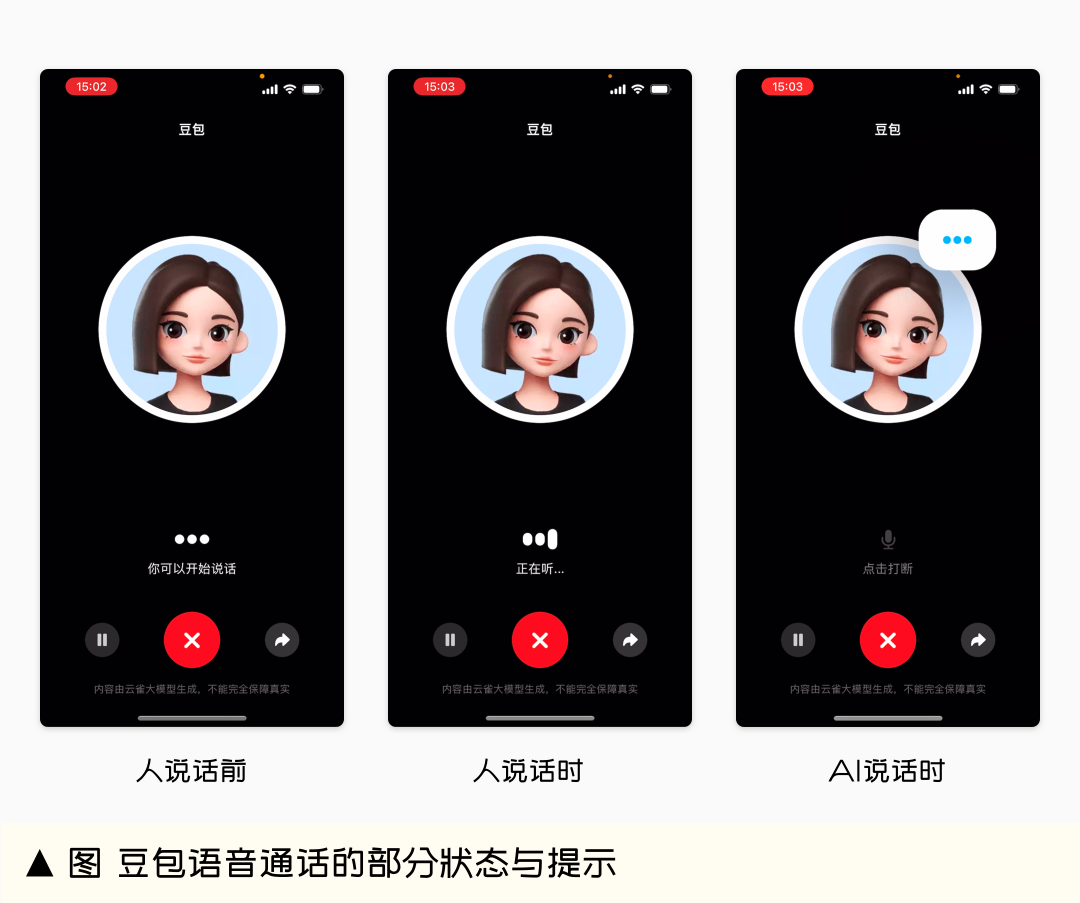
前面说的都是单点优化,真正决定 AI语音通话对话 自不自然的,其实是整体延迟和交互节奏。我实测下来,从用户说完到 AI 开口,超过 1.5 秒就会觉得卡,超过 2 秒就想挂电话。所以能并行的步骤尽量并行,识别还没完全结束就可以先把中间结果给模型预热。打断也一样,用户一开口,TTS 得马上停,识别得马上切过去听。这中间状态管理挺麻烦的,但做不好前面全白搭。还有网络抖动,尤其移动端,丢包一多语音就断断续续,有条件的话上点抗丢包策略,或者至少给个缓冲。
普通人想尝鲜,怎么快速搭一套试试
如果你不是开发者,只是想体验下 AI语音通话对话,现在有些平台把识别、模型、合成打包好了,注册就能用,调调参数就行。但要注意免费额度通常延迟高、音色少,想流畅还是得花点钱。自己搭的话,建议先用现成 API 跑通链路,再逐步替换优化。别一上来就追求全本地部署,光显卡就够你折腾的。我一开始也想省事全用开源,结果调了一周还没跑顺,后来换回云服务先把流程跑通,再局部替换,效率高多了。
总的来说,AI语音通话对话 想做到自然流畅,没有哪个单点能一招制胜,得把识别、理解、合成、延迟、打断这几块都照顾到。哪块短板太明显,用户一下就能听出来。多实测、多调参,慢慢就能找到手感。
 喜欢
 高兴
 鬼脸
 呵呵
 无聊
 伤心